Am 3. September 2026 hat Snowflake External Lineage allgemein verfügbar gemacht. Schicken Sie ihm OpenLineage-Ereignisse über REST, und es setzt Objekte, die außerhalb von Snowflake liegen — ein S3-Präfix, eine Postgres-Tabelle, was Ihre Pipeline tatsächlich gelesen hat — in den Lineage-Graphen neben Ihre eigenen Tabellen. dbt und Airflow emittieren bereits OpenLineage, für viele Teams ist das also eine Konfigurationsänderung und kein Projekt.
Das ist wirklich gut, und die Pipeline-Hälfte § 1 hat vor sechs Wochen genau für dieses Ergebnis argumentiert: Nehmen Sie den offenen Standard, weil proprietäre Lineage sowohl die Portabilität als auch die Abdeckung Ihres Graphen von einer Geschäftsbeziehung abhängig macht. Ein Warehouse, das OpenLineage als Ingest-API übernimmt, ist genau diese Wette, die aufgeht.
Dieser Beitrag ist also keine Beschwerde. Er stellt die nützlichere Frage, die nach der guten Nachricht kommt: Wenn die Ereignisse einmal drin sind, was behält Snowflake davon eigentlich?
Ich habe einen Vormittag damit verbracht, das herauszufinden, gegen einen kostenlosen Testaccount, und die Antwort ist schärfer, als ich erwartet hatte.
Snowflake behält die Adressierung — woher die Daten kamen, wohin sie gingen, welche Spalten, welcher Lauf, wann. Es verwirft die Bedeutung — warum verarbeitet wurde, auf welcher Rechtsgrundlage, aus welchem Commit, und sogar, wie der Job hieß.
Diese Unterscheidung entscheidet darüber, ob Sie darauf etwas aufbauen können.
Zwei der drei Verhaltensweisen unten stehen in der Dokumentation, und ich habe sie bestätigt, nicht entdeckt — was sich lohnt, weil das eine nur als Beispiel und das andere nur im Umriss dokumentiert ist. Das dritte ist nirgends dokumentiert, und es ist dasjenige, das entscheidet, was Sie bauen können.
Was getestet wurde, und wie Sie es wiederholen
Alles Folgende stammt aus einem 30-tägigen Snowflake-Testaccount ohne hinterlegtes Zahlungsmittel. External Lineage braucht die Enterprise Edition, die bei der Registrierung gewählt wird und danach nicht mehr änderbar ist, und die beiden Privilegien, die das Feature verlangt — INGEST LINEAGE und DELETE LINEAGE — lassen sich auf einem Testaccount anstandslos an eine Rolle vergeben, woraufhin der REST-Endpunkt antwortet. Nichts davon setzte eine bezahlte Beziehung zu Snowflake voraus, also muss nichts davon geglaubt werden.
Eine Falle, die zu benennen sich lohnt, bevor sie einen Tag kostet: Die dokumentierte Liste der Testaccount-Einschränkungen enthält „external network access“, also Snowflake, das nach außen greift. Das ist ein anderes Feature als External Lineage, das ein eingehender POST an Snowflakes eigene API ist. Die Namen kollidieren, und der falsche Schluss liegt nahe.
Das Prüfwerkzeug besteht aus einem Skript, das ein JWT signiert, und einem, das SQL über die REST-API ausführt, beide ohne mehr als die Python-Standardbibliothek und openssl. Die Authentifizierung läuft ausschließlich über ein Schlüsselpaar — Benutzername und Passwort öffnen diese Tür nicht.
Die Nutzlast war ein einzelnes COMPLETE-Ereignis nach dem Vorbild dessen, was unsere eigene Pipeline-Runtime emittiert: ein S3-Präfix als Eingabe, eine Snowflake-Tabelle als Ausgabe, dazu vier Facets. Zwei dieser Facets sind die, die die Pipeline-Hälfte § 1 an jedes Ereignis hängt:
"job": {
  "namespace": "cordata.fraud",
  "name": "transactions-scored-daily",
  "facets": {
    "processing": {
      "purpose": "fraud-detection",
      "legal_basis": "legitimate-interest"
    }
  }
}
Diese beiden Felder sind keine Dekoration. Der Governance-Begleitbeitrag § 2 erzeugt daraus ein DSGVO-Art.-30-Verzeichnis, indem er sie aus dem Lineage-Strom projiziert. Überstehen sie den Weg, kann das Warehouse diesen Nachweis halten. Wenn nicht, muss etwas anderes es tun.
Bestätigt: Nur Erfolge werden zugelassen
Die Dokumentation sagt, der Endpunkt nehme COMPLETE-Ereignisse an, und nennt START und FAIL als Beispiele für das, was er ablehnt. Es lohnt sich, den ganzen Satz zu testen statt nur der beiden genannten, denn die Antwort fällt absolut aus:
gesendeter eventType |
Antwort |
|---|---|
COMPLETE |
200 |
FAIL |
400 |
START |
400 |
RUNNING |
400 |
ABORT |
400 |
Jede Ablehnung trägt denselben Body:
{"code": "394902",
 "message": "Unsupported event type, only COMPLETE event type can be ingested"}
Der Graph enthält also erfolgreiche Läufe und sonst nichts. Keine Fehlschläge, keine laufenden Läufe, keine Abbrüche.
Als Designentscheidung über einen Lineage-Graphen gelesen, ist das vertretbar und vermutlich richtig. Lineage hält fest, welche Datensätze aus welchen entstehen, und ein fehlgeschlagener Lauf hat keinen Datensatz erzeugt, auf den eine Kante zeigen könnte. Niemand will eine Fläche voller Pfeile auf Tabellen, die nie geschrieben wurden.
Als Nachweisspeicher gelesen ist es fatal, und zwar aus einem bestimmten Grund. Teil 2 § 3 macht Prüfergebnisse zu einem Datenqualitäts-Facet am Lauf, und § 4 formuliert die Provenienz-Regel, nach der dieses Blog arbeitet: Ein Lauf, dessen Provenienz auf einen unsignierten Commit zeigt, ist selbst ein Befund. Beides sind Aussagen über Läufe, die schiefgegangen sind. Eine Senke, die auf FAIL mit 400 antwortet, kann genau den Datensatz nicht halten, nach dem ein Prüfer zuerst fragt.
Der fehlgeschlagene Lauf ist in der Governance kein Randfall, er ist der zentrale Fall.
Halb dokumentiert: Welche Facets überleben und welche nicht
Das Ereignis ging hinein und lieferte 200 zurück. Das hier kam wieder heraus.
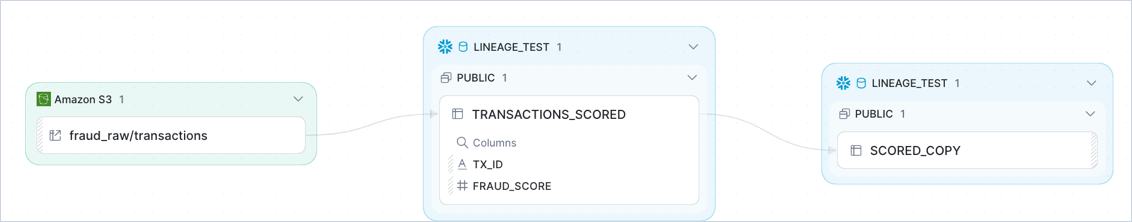
Das externe S3-Objekt erscheint als vollwertiger Knoten neben Snowflake-Tabellen. SCORED_COPY rechts ist native Lineage aus einem CREATE TABLE … AS SELECT und dient als Kontrolle.
Das Spalten-Facet hat unbeschadet überlebt:
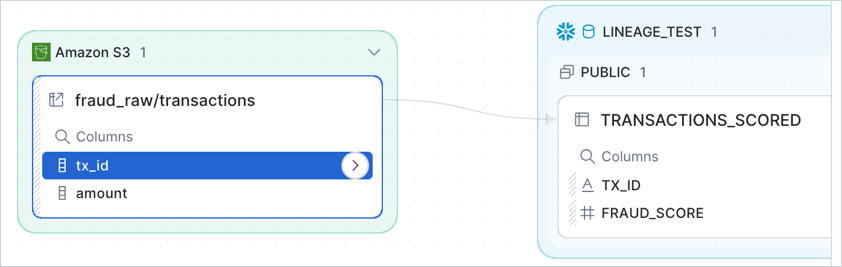
tx_id und amount kommen in der Nutzlast nirgends vor außer im columnLineage-Facet. Die Zuordnung ist gespeichert und nicht geraten — amount wurde absichtlich auf FRAUD_SCORE abgebildet, auf beiden Seiten unterschiedlich benannt, und kam korrekt zurück.
Das ist eine echte Fähigkeit und gehört deutlich gesagt: Spaltengenaue Lineage über eine Systemgrenze hinweg, aus einem JSON-Dokument, ist nicht nichts.
Nun die Kante selbst auswählen:
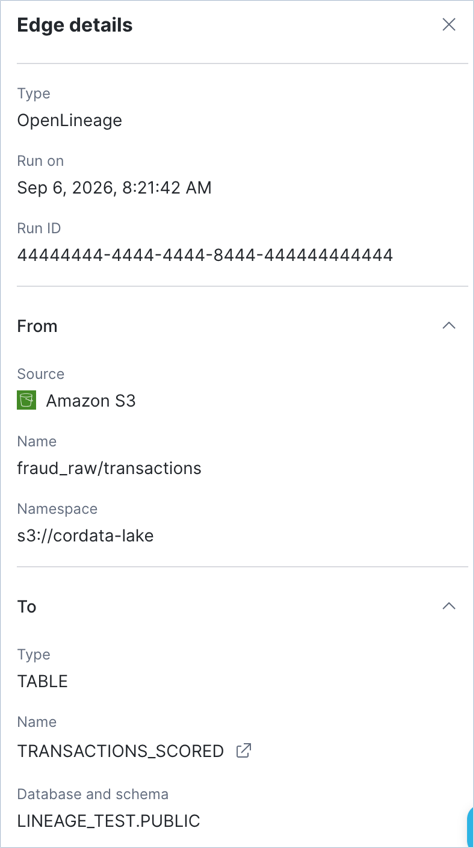
Der vollständige gespeicherte Datensatz einer External-Lineage-Kante. Das Panel endet dort, wo der Screenshot endet.
Type, Run on, Run ID, woher es kam, wohin es ging. Das Panel des externen Knotens ist noch kürzer — Quelle, Typ, Namespace, und damit hat es sich. Der Typ ist dabei echte Information und kein Platzhalter: Schickt man das datasetType-Facet mit, meldet der Knoten FILE statt des generischen External Node, und das ist das zweite der beiden Facets, die Snowflake dokumentiert.
Es gibt kein purpose und kein legal_basis, und auch kein sourceCodeLocation, mit dem ein Lineage-Ereignis auf den Commit zeigt, der den Lauf erzeugt hat. Der Name des Jobs selbst, transactions-scored-daily, fehlt — der Graph weiß, dass ein Lauf stattgefunden hat, ohne festzuhalten, was gelaufen ist.
Die vollständige Abrechnung dessen, was hineinging, gegen das, was zurückkam:
| Gesendet | Behalten |
|---|---|
| Namespaces und Namen von Ein- und Ausgabe | ja |
columnLineage-Facet |
ja |
datasetType-Facet |
ja |
run.runId, eventTime |
ja |
job.name, job.namespace |
nein |
producer |
nein |
sql, sourceCode, sourceCodeLocation |
nein |
parent — welcher DAG und welcher Task |
nein |
ownership, documentation |
nein |
jobType, processing_engine, nominalTime |
nein |
dataSource, storage |
nein |
dataQualityMetrics, outputStatistics |
nein |
processing.purpose, processing.legal_basis |
nein |
Die Regel ist exakt, und Snowflake sagt sie klar, wenn man darauf achtet: Es behält die Adressierung, dazu die beiden Facets, die die Dokumentation nennt. columnLineage und datasetType funktionieren genau wie beschrieben. Alles Übrige aus der OpenLineage-Spezifikation wird verworfen.
Diese Tabelle sollte man abgestuft lesen statt flach, denn sie mischt drei sehr unterschiedliche Behauptungen.
processing.purpose und processing.legal_basis sind unsere. Ein eigenes Facet, nicht Teil der OpenLineage-Spezifikation, und Snowflake hat nie zugesagt, es zu behalten. Dass es verworfen wird, ist unauffällig, und darauf würde ich keinen Beitrag bauen.
sql, parent, ownership und sourceCodeLocation gehören OpenLineage selbst. Das sind Facets, die die Spezifikation definiert, und genau das, was die von Snowflake empfohlenen Integrationen tatsächlich emittieren. Das wiegt schwerer.
job.name, job.namespace und producer sind überhaupt keine Facets. Sie sind Pflichtfelder eines RunEvent. Der Satz der Dokumentation — „The payload can contain additional properties, but Snowflake ignores them.“ — deckt sie nicht ab, denn sie sind nicht zusätzlich, sie sind das Ereignis.
Was dbt und Airflow an eigenen Metadaten verlieren
Der naheliegende Einwand gegen alles Obige lautet, ich hätte diese Ereignisse von Hand geschrieben, und dbt oder Airflow — die beiden Integrationen, die Snowflake nennt — bekämen aus ihrer eigenen Pipeline vielleicht mehr. Bekommen sie nicht, und die Dokumentation sagt es zuerst — im Original, weil es hier auf den Wortlaut ankommt:
Configuring dbt to emit OpenLineage events isn't unique to Snowflake; the only thing specific to Snowflake is the endpoint and base URL of external lineage.
Nichts Snowflake-Spezifisches also außer Endpunkt und Basis-URL. Derselbe Satz steht für Airflow. Es ist so oder so JSON über REST, und der Endpunkt kann mein curl von niemandes Emitter unterscheiden.
Ich habe es trotzdem getestet, mit producer auf die URL der dbt-Integration gesetzt und passendem User-Agent, mit elf Standard-Facets. Das Panel kam identisch zurück.
Der Verlust beschränkt sich also nicht auf unsere Governance-Facets. parent ist die Art, wie Airflows Integration festhält, welcher DAG und welcher Task einen Lauf erzeugt hat, und es wird verworfen, sodass ein Airflow-Nutzer an einer Kante in Snowsight nicht erkennen kann, welche Pipeline sie geschrieben hat. Auch das sql-Facet, das dbt selbstverständlich mitschickt, wird verworfen — die Abfrage, die die Tabelle gebaut hat, steht also ebenfalls nicht dort.
Der Graph weiß, dass ein Lauf stattgefunden hat, ohne festzuhalten, was gelaufen ist.
Der Befund: Sie können den Graphen ansehen und nicht abfragen
Das ist der, den ich nicht kommen sah, und ich habe ihn zweimal falsch beurteilt, bevor er stimmte.
Snowflake stellt Lineage über SNOWFLAKE.CORE.GET_LINEAGE für SQL bereit. Richtet man die Funktion auf die Tabelle und geht stromabwärts, ist die native Kante da. Richtet man sie auf dieselbe Tabelle, im selben Moment, und geht stromaufwärts zum externen Objekt, das die Konsole gerade auf den Schirm zeichnet:
SELECT SOURCE_OBJECT_NAME, TARGET_OBJECT_NAME, DISTANCE
FROM TABLE(SNOWFLAKE.CORE.GET_LINEAGE(
  'LINEAGE_TEST.PUBLIC.TRANSACTIONS_SCORED', 'TABLE', 'UPSTREAM', 3));
0 rowsStromabwärts liefert sie eine Zeile, stromaufwärts nichts — während die Screenshots oben auf dem Schirm standen.
Es gibt kein Argument, das das einschaltet. Die ausgelieferte Signatur lautet GET_LINEAGE(object_name, object_domain, direction, max_distance, object_version); es gibt keinen Namespace-Parameter und kein Flag für externe Objekte. 'EXTERNAL' als Domain liefert „Unknown domain.“ Und SNOWFLAKE.ACCOUNT_USAGE enthält überhaupt keine Lineage-View, es gibt also auch keine zweite Tür.
Die externe Hälfte des Graphen wird in der Konsole gezeichnet und ist aus SQL nicht erreichbar.
Für eine Analystin, die eine Tabelle zu ihrer Quelle zurückverfolgt, ist das in Ordnung. Für ein Plattform-Team, das mit dem Graphen etwas tun will, ist das das ganze Problem. Aus einem Bild lässt sich kein Bericht erzeugen. Man kann es nicht zwischen Umgebungen diffen, nicht in CI darauf prüfen, nicht in ein Art.-30-Verzeichnis projizieren und keiner Control Plane vorlegen.
Metadaten, die man nicht abfragen kann, sind Dokumentation mit besserer Darstellung — und Dokumentation ist genau das, was ein Descriptor aufhören soll zu sein.
Eine 200 heißt nicht, dass es gespeichert wurde
Noch eine Sache, und es ist die, die mir im Produktivbetrieb am meisten Sorgen machen würde.
Ich habe dasselbe Ereignis fünfmal mit fünf Schreibweisen des Snowflake-Namespace geschickt, um herauszufinden, welche Form der Endpunkt haben will. Alle fünf lieferten 200 mit leerem Body, darunter eine, die nach keiner Lesart ein gültiger OpenLineage-Namespace ist, weil sie gar kein Schema hat. Nur eine der fünf wurde zur Kante im Graphen.
Es gibt keine Bestätigung, keine Kennung, keine Zahl geschriebener Kanten und keinen Fehler. Und weil externe Kanten aus SQL nicht gelesen werden können, gibt es auch hinterher keine Möglichkeit zu prüfen. Ein Producer, der planmäßig in diesen Endpunkt emittiert, hat kein Signal zur Verfügung, das gespeichert und verknüpft von angenommen und verworfen unterscheidet.
Wenn Sie das verkabeln, ist der Prüfschritt ein Data Engineer, der die Konsole öffnet.
Was ich zweimal falsch hatte
Zwei Korrekturen, denn ein Beitrag darüber, ob ein System ehrlich meldet, was es getan hat, sollte ehrlich sagen, wie lange sein Autor gebraucht hat, um das herauszufinden.
Ich schloss, die Ereignisse würden verworfen. GET_LINEAGE lieferte wiederholt nichts, über fünfundzwanzig Minuten. Ich habe eine Kontrolle laufen lassen — ein CREATE TABLE … AS SELECT innerhalb von Snowflake, über dieselbe Funktion im selben Moment abgefragt — und die native Kante erschien in etwa zehn Sekunden. Lesepfad in Ordnung, Latenz nicht die Erklärung, also musste der Ingest fehlgeschlagen sein. Diese Argumentation war sauber und der Schluss falsch: Die Konsole zeigte die Kante die ganze Zeit. Der Fehler lag doch im Lesepfad, nur nicht so, dass eine funktionierende Kontrolle ihn hätte zeigen können.
Die Dokumentation beschrieb eine Funktion, die es nicht gibt. Die veröffentlichte Anleitung zum Abfragen externer Objekte nennt ein namespace-Argument und eine object_domain von 'EXTERNAL'. Beides steckt nicht in der ausgelieferten Funktion. SHOW FUNCTIONS LIKE 'GET_LINEAGE' IN SCHEMA SNOWFLAKE.CORE lieferte die echte Signatur in einer Zeile und klärte in Sekunden, was mich die Doku eine halbe Stunde gekostet hatte. Bei einem sechs Wochen alten GA-Feature lohnt es sich, den Account zu befragen statt das Handbuch.
Was das heißt, wenn Sie es verkabeln
Snowflakes External Lineage ist ein Lineage-Betrachter, und ein guter. Spaltengenauigkeit über eine Systemgrenze hinweg, externe Objekte als vollwertige Knoten, keine eigene Integration zu schreiben. Wenn die Aufgabe lautet eine Analystin öffnet eine Tabelle und fragt, woher das kam, erledigt es diese Aufgabe gut und kostet eine Konfigurationsänderung.
Ein Nachweisspeicher ist es nicht, und die Unterscheidung ist keine Wortklauberei:
- Es lässt nur Erfolge zu, kann also den fehlgeschlagenen Lauf nicht halten.
- Es behält Adressierung und verwirft Bedeutung, kann also nicht beantworten, warum oder auf welcher Grundlage.
- Für die externe Hälfte ist es nicht abfragbar, es lässt sich also nichts darauf automatisieren.
- Es bestätigt beim Schreiben nichts, Sie können also nicht prüfen, was es hält.
Nichts davon ist ein Mangel an einem Lineage-Betrachter. Alle vier sind in einem Prüfpfad disqualifizierend. Der Fehler — und er liegt nahe, weil es buchstäblich dieselben Ereignisse sind — besteht darin, „wir emittieren OpenLineage nach Snowflake“ für die Erfüllung der Pflicht zu halten. Das Wire-Format ist geteilt, die Aufbewahrungspolitik nicht.
Eine Zielgruppe wird gut bedient, eine andere gar nicht
Die Fabric-+-Mesh-Referenz § 4 sortiert diese Fragen danach, wer fragt, und so liest man auch dieses Release richtig.
Data Engineers, Analystinnen und Domänen-Engineers bekommen ein gutes Geschäft. Ihre Frage lautet woher kam diese Tabelle, und welche Spalte speiste welche. Sie wird in der Konsole beantwortet, spaltengenau, über eine Systemgrenze hinweg, zum Preis, eine vorhandene dbt- oder Airflow-Integration auf eine andere URL zu richten. Für diese Zielgruppe ist das Release schlicht eine gute Nachricht, und der Rest dieses Beitrags gilt für sie nicht.
Das Plattform-Team bekommt ein halbes Geschäft. Alles, was es automatisieren wollte — in CI prüfen, dass keine undeklarierte Quelle eine veröffentlichte Tabelle speist, den Graphen zwischen Staging und Produktion diffen, alarmieren, wenn eine Kante verschwindet — braucht den Graphen in SQL, und die externe Hälfte ist dort nicht. Ansehen ja, darauf bauen nein.
Der Datenschutzbeauftragte, der Governance-Rat und der Prüfer bekommen nichts Brauchbares. Nicht, weil Snowflake das schlecht gemacht hätte, sondern wegen dessen, was Art. 30 tatsächlich verlangt. Das Verzeichnis von Verarbeitungstätigkeiten ist eine Pflicht des Verantwortlichen — der Organisation — und nicht eines Systems. Es muss jede Verarbeitungstätigkeit abdecken, auch die, die das Warehouse nie berühren: die Lambda, die eine Datei an Ort und Stelle bewertet, das SaaS-Werkzeug, das ein Domänen-Team gekauft hat, den Export, der zu einem Auftragsverarbeiter geht. Ein Lineage-Graph pro Werkzeug kann eine Pflicht, die beim Verantwortlichen liegt, selbst dann nicht erfüllen, wenn er perfekt ist — und dieser verwirft zusätzlich den Zweck, die Rechtsgrundlage und jeden fehlgeschlagenen Lauf.
Die zweite Senke ist also keine Redundanz und kein doppelter Boden. Sie ist der einzige Ort, an dem sich eine systemübergreifende Frage beantworten lässt, und Art.-30-Fragen sind ausnahmslos systemübergreifend. Der Warehouse-Graph beantwortet woher kam diese Tabelle. Das ganzheitliche Verzeichnis beantwortet was tut diese Organisation mit personenbezogenen Daten, auf welcher Grundlage, und können Sie es mir zeigen — und die Konsole eines einzelnen Werkzeugs wird nie der Ort sein, an dem das lebt.
Was etwas schärft, das die Pipeline-Hälfte § 1 halb richtig hatte. Jener Beitrag argumentierte für OpenLineage mit der Begründung, ein proprietärer Katalog mache Portabilität und Abdeckung von einem Anbieter abhängig. Dass Snowflake den Standard übernimmt, liefert Interoperabilität — derselbe Emitter speist jetzt eine weitere Senke, ohne Adapter, und das ist real. Es liefert keine Portabilität, denn Portabilität hängt davon ab, wo Ereignisse landen, wie lange sie leben und ob man sie wieder herausbekommt. Nichts davon entscheidet das Format, in dem sie gereist sind.
Also: einmal emittieren, zweimal landen. Schicken Sie die Ereignisse an Snowflake, weil der Graph für die Engineers und Analystinnen, die diese Konsole öffnen, wirklich nützlich ist. Und landen Sie dieselben Ereignisse zusätzlich dort, wo Sie die Kontrolle haben, denn aus dieser Kopie wird die Frage des Datenschutzbeauftragten beantwortet — der Kopie, auf der noch purpose und legal_basis stehen, in der noch der fehlgeschlagene Lauf steckt und die auch die Verarbeitung enthält, die nie in die Nähe des Warehouse kam.
Die Probes, die Nutzlasten und die rohen Antworten liegen in cordata-tech/snowflake-external-lineage-probe, einschließlich der Hypothese, die sich als falsch herausstellte. Alles darin läuft gegen einen kostenlosen Testaccount.
Wenn Sie OpenLineage an Snowflake angebunden haben und die Aufbewahrung anders vorfinden als hier — oder finden, ein Lineage-Graph sollte die Governance-Facets nie tragen und ich verlange das Falsche von ihm —, würde ich das gern hören. Die Tür steht offen unter cordata.tech/contact. Weiterführend: Eine Pipeline ist ein Descriptor, kein Programm und die Pipeline-Hälfte sind die beiden Beiträge, die dieser hier prüft, und Behaviour-first-Governance in der Praxis geht die Art.-30-Projektion durch, die diese Facets speisen.